Benchmark de UX é uma prática de medição repetível: a equipe define tarefas importantes, coleta métricas em condições documentadas e acompanha a experiência em relação a uma referência. O valor não está em produzir um ranking, mas em mostrar se uma mudança melhorou uma tarefa, para qual público e com que grau de incerteza.
Um bom estudo começa com uma pergunta de decisão, cria uma linha de base, mantém o protocolo estável, registra os dados brutos e repete a medição depois da mudança. Este guia mostra como planejar o benchmarking UX do zero, escolher métricas, analisar resultados e evitar conclusões que os dados não sustentam.
Se uma equipe diz que a nova versão ficou “mais fácil”, ainda falta responder: mais fácil em qual tarefa, para qual pessoa, em comparação com qual estado e com qual evidência? O benchmark de UX transforma essa afirmação em uma medida que pode ser repetida e discutida com transparência.
A Nielsen Norman Group define UX benchmarking como a avaliação quantitativa de um produto ou serviço em relação a um padrão relevante. Esse padrão pode ser uma versão anterior, uma meta do negócio, um padrão de mercado ou outra referência que faça sentido para a decisão. A prática é especialmente útil quando a organização quer acompanhar a evolução ao longo de vários ciclos de produto.
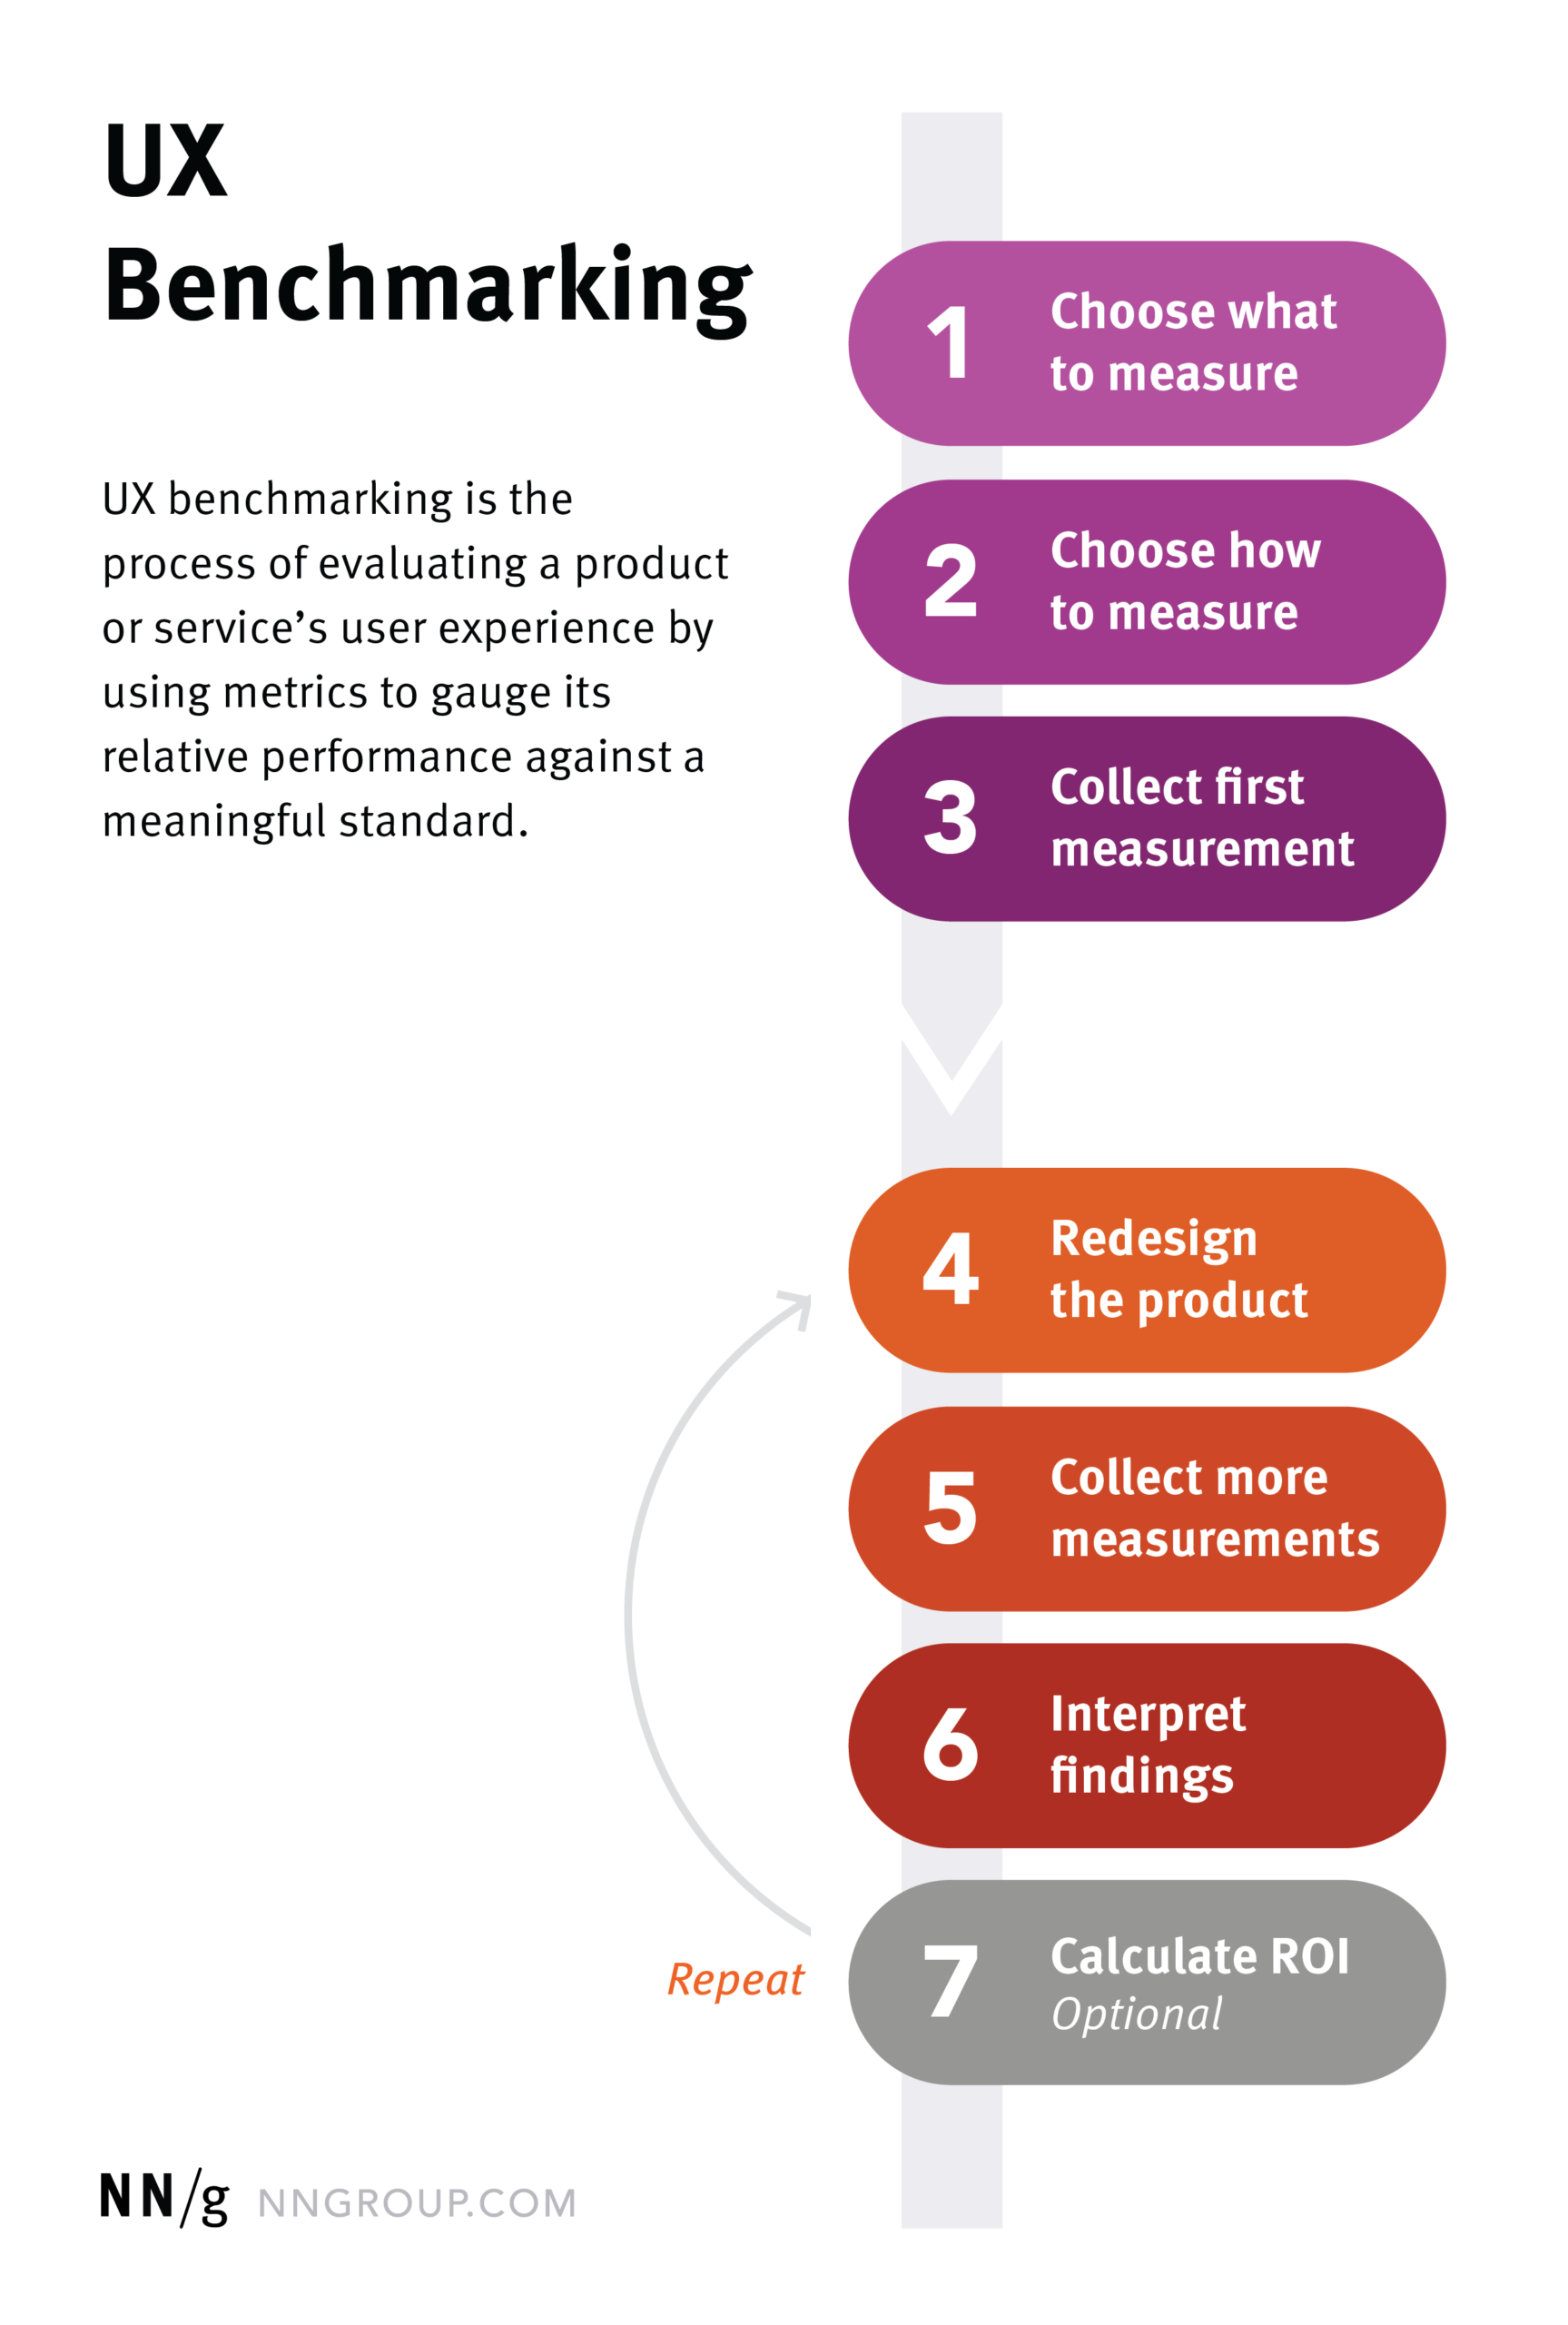
O que é benchmark de UX?
Benchmark de UX é um estudo avaliativo que mede o desempenho de uma experiência com indicadores definidos antes da coleta. A equipe escolhe tarefas relevantes, recruta ou identifica um público, aplica um protocolo e compara os resultados com uma referência explícita.
A palavra benchmark pode designar tanto a referência usada na análise quanto o programa de medição que produz e acompanha essa referência. No contexto de UX, o uso mais útil é tratar benchmarking como um processo contínuo, e não como uma apresentação isolada com capturas de tela.
Uma métrica só ganha significado quando a equipe sabe qual tarefa representa, como foi calculada e contra qual referência está sendo lida.
O benchmark também não é uma promessa de causalidade. Se o tempo de uma tarefa diminuiu, o dado mostra uma diferença nessa medida. Para afirmar que uma mudança de interface causou o resultado, é preciso controlar o desenho do estudo, verificar a qualidade da coleta e considerar outras explicações possíveis.
Para que serve o benchmarking UX?
O objetivo principal é tornar a evolução observável. Em vez de depender apenas da percepção de quem desenhou ou aprovou uma tela, a equipe acompanha um conjunto pequeno de indicadores que representam tarefas importantes.
- Acompanhar uma evolução: verificar se uma versão posterior mudou o desempenho de uma tarefa em relação à linha de base.
- Dar foco ao investimento: mostrar quais jornadas têm maior diferença entre a situação observada e a meta definida.
- Conectar UX e produto: relacionar uma medida de experiência a adoção, retenção, conversão, eficiência ou redução de suporte, sem atribuir o resultado automaticamente ao design.
- Criar memória institucional: preservar o que foi medido, em quais condições e com qual definição, mesmo quando pessoas e ferramentas mudam.
- Reduzir decisões por anedota: substituir o caso mais chamativo por uma leitura de recorrência, distribuição e contexto.
A NN/g descreve benchmarking como uma prática somativa, normalmente realizada quando uma versão está suficientemente definida para ser medida. Isso não impede medições em produtos em evolução. Significa apenas que a equipe precisa declarar qual versão, tarefa e contexto aquele retrato representa.
Benchmark, baseline e meta: qual é a diferença?
Os termos aparecem juntos, mas cumprem funções diferentes no plano de medição:
| Termo | Função no estudo | Exemplo |
|---|---|---|
| Baseline | Primeira medida confiável que descreve o estado inicial. | Tempo mediano para concluir o cadastro na versão atual. |
| Benchmark | Prática repetível de medir e interpretar o desempenho contra uma referência. | Rodadas trimestrais com a mesma tarefa e as mesmas regras. |
| Meta | Resultado desejado que orienta a decisão, sem ser automaticamente uma norma externa. | Aumentar o sucesso da tarefa sem elevar o número de erros. |
| Delta | Diferença observada entre duas medidas ou entre uma medida e a referência. | Sucesso passou de 72% para 81%. |
Sem baseline, a equipe pode até medir a versão nova, mas não sabe com segurança de onde partiu. Sem uma definição de meta, uma melhora pequena pode ser celebrada sem relação com a decisão. E sem registrar o delta e sua incerteza, o número pode parecer mais preciso do que realmente é.
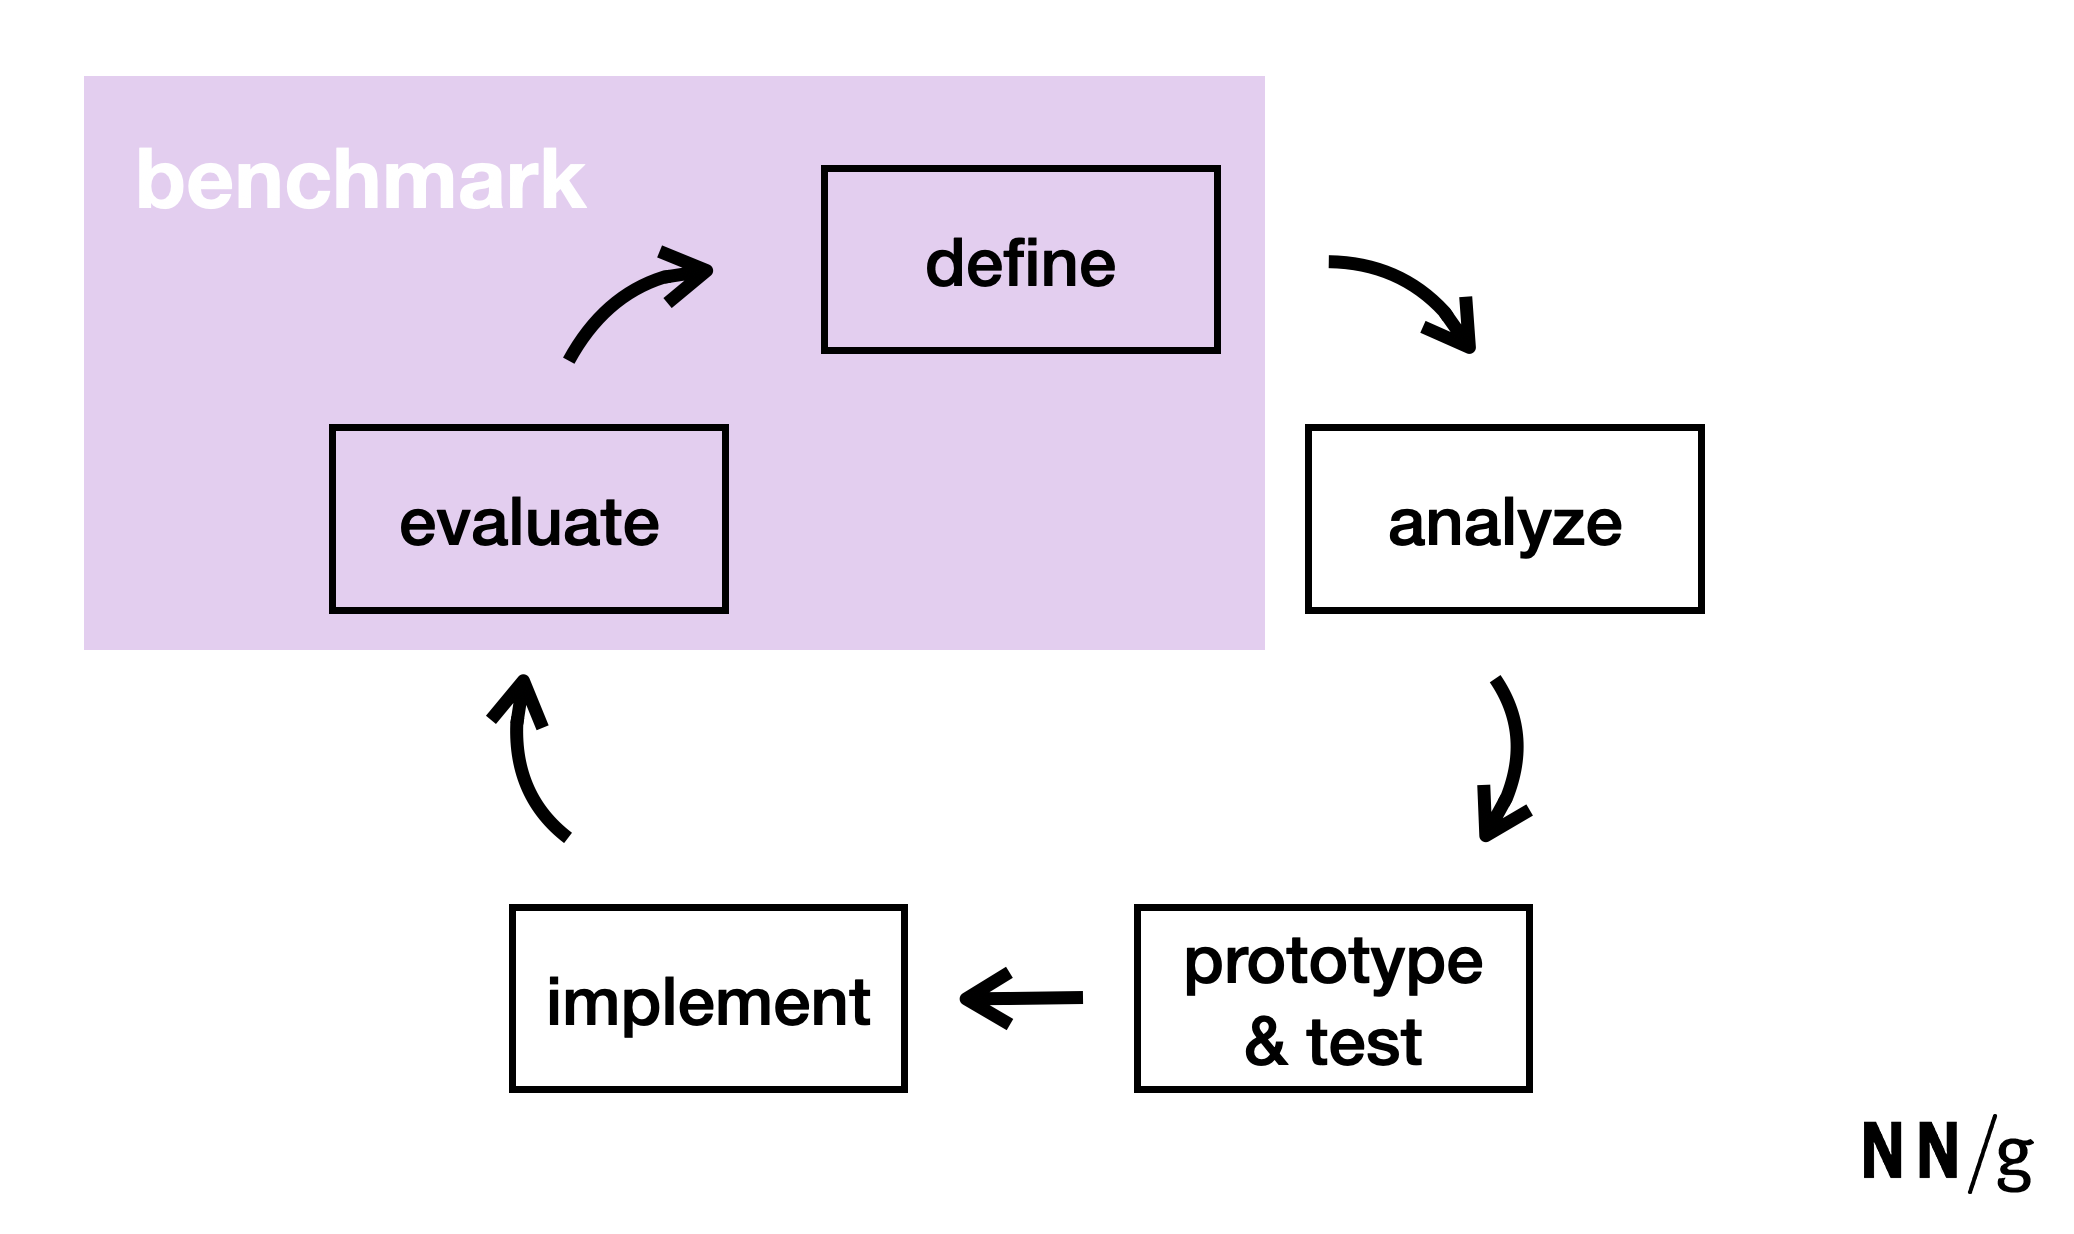
Como planejar um benchmark de UX em 9 etapas
1. Comece pela decisão, não pela métrica
Escreva a decisão que poderá mudar depois do estudo. Por exemplo: “devemos priorizar a simplificação do cadastro para novos clientes?” ou “a próxima versão mantém o desempenho mínimo esperado no fluxo de pagamento?”. A decisão define o recorte, o nível de precisão necessário e o que será feito com o resultado.
Uma pergunta como “qual é a melhor experiência?” é ampla demais. Prefira uma formulação que contenha um comportamento observável, um público e um contexto. Se a equipe não sabe qual decisão seria tomada em cada cenário, o estudo ainda não está pronto para a coleta.
2. Escolha o produto, a versão e o recorte
Registre a versão exata do produto, o ambiente de acesso, o dispositivo, o idioma, a data da coleta e as funcionalidades disponíveis. Em uma aplicação, documente também integrações, dados de teste e permissões que podem alterar o comportamento.
Defina quais segmentos precisam ser analisados separadamente. Misturar pessoas novas e recorrentes, por exemplo, pode esconder uma diferença importante de aprendizagem. Se a equipe não tiver amostra suficiente para separar segmentos, declare essa limitação no plano.
3. Selecione as tarefas mais importantes
Escolha tarefas que representem objetivos reais do público e que tenham impacto no produto. A NN/g recomenda começar pelas top tasks e selecionar um conjunto pequeno, geralmente entre cinco e dez tarefas quando o programa está sendo criado. Esse intervalo é uma orientação de planejamento, não uma regra estatística.
- Descreva o objetivo em linguagem de cenário, sem entregar o caminho da interface.
- Defina o ponto de início e a condição objetiva de sucesso.
- Liste pré-requisitos, dados fictícios, credenciais e limites de tempo.
- Classifique a tarefa por frequência, risco, valor para o usuário e impacto para o negócio.
- Evite mudar a redação entre rodadas sem registrar uma nova versão do protocolo.
4. Escolha de 2 a 4 métricas complementares
Mais indicadores não significam necessariamente mais conhecimento. Escolha poucas métricas que cubram dimensões diferentes da experiência, como comportamento, eficiência e percepção. A escolha precisa permanecer estável o bastante para ser repetida e flexível o bastante para responder à decisão.
Documente a fórmula, a unidade, o denominador, os critérios de exclusão e a regra para dados ausentes. A palavra “sucesso”, por exemplo, pode significar chegar a uma tela, concluir uma ação ou realizar o objetivo completo. A definição precisa dizer qual dessas condições vale.
5. Escreva o protocolo antes de coletar
O protocolo é o contrato de comparabilidade do benchmark. Ele deve registrar recrutamento, instruções, ordem das tarefas, modalidade, duração, dispositivo, presença de moderador, uso de pensar em voz alta, regras de ajuda, critérios de sucesso e forma de codificação.
A NN/g alerta que mudar de estudo presencial para remoto não moderado, por exemplo, pode alterar tempo e comportamento mesmo que o produto não tenha mudado. Se a mudança metodológica for necessária, registre-a e avalie se a nova rodada deve iniciar uma série diferente.
6. Colete a primeira medida e estabeleça a baseline
Faça um piloto para descobrir ambiguidades no roteiro, falhas de instrumentação e tarefas impossíveis. Depois, execute a rodada de baseline com o protocolo aprovado. Guarde dados brutos, gravações permitidas, logs, respostas de questionário, notas de campo e decisões de exclusão.
Não corrija o produto no meio da rodada sem registrar a alteração. Se um defeito crítico exigir interrupção, encerre a rodada, documente o motivo e trate a coleta seguinte como uma nova versão do estudo.
7. Faça a mudança de produto com a hipótese explícita
Conecte cada mudança a uma hipótese: “se reduzirmos os campos obrigatórios, esperamos diminuir abandono sem aumentar erros de validação”. A hipótese ajuda a definir quais métricas devem melhorar e quais guardrails não podem piorar.
Não transforme o benchmark em uma lista de correções obrigatórias. O estudo mostra um desempenho e a mudança é uma decisão de produto que também depende de tecnologia, conteúdo, acessibilidade, risco e estratégia.
8. Repita a medição em condições comparáveis
Repita as tarefas, as definições e as condições relevantes. Não é necessário recrutar as mesmas pessoas. É mais importante que o novo grupo seja selecionado com critérios equivalentes e represente o público que a decisão pretende atender.
Registre tudo que mudou: versão do produto, sazonalidade, campanha, composição da amostra, dispositivo, ferramenta, tempo de campo e qualquer alteração no roteiro. Uma diferença explicada é mais útil do que uma falsa aparência de estabilidade.
9. Interprete, decida e arquive
Apresente o resultado com a medida anterior, a medida atual, a diferença, o intervalo de incerteza, a distribuição e a implicação para a decisão. Depois, registre a decisão tomada e guarde a documentação para a próxima rodada.
Quais métricas usar em um benchmark de UX?
As melhores métricas são as que traduzem a qualidade de uma tarefa para a decisão do produto. Uma métrica não precisa ser sofisticada para ser útil. Ela precisa ser compreensível, repetível e ligada a um comportamento que a equipe consegue influenciar.
| Métrica | Como definir | Cuidados de interpretação |
|---|---|---|
| Sucesso na tarefa | Proporção de participantes que atingem o critério de sucesso definido. | Declare sucesso total, parcial, falha e casos de ajuda. |
| Tempo na tarefa | Tempo entre o início e o momento em que a condição de término é atingida. | Use mediana quando poucos casos muito longos distorcem a média. |
| Erros | Ocorrências de ações incorretas previamente codificadas. | Defina o que é erro antes de ver os resultados. |
| Abandono | Proporção de pessoas que deixam a tarefa sem concluir. | Separe abandono de falha técnica, falta de tempo e interrupção externa. |
| Ajuda | Pedidos de orientação ou intervenção necessários para concluir. | Registre o tipo de ajuda e se ela invalida o sucesso. |
| Satisfação ou facilidade | Resposta a uma escala ou pergunta padronizada depois da tarefa. | Não trate percepção como substituta do comportamento observado. |
| Retenção ou retorno | Percentual que continua usando o produto em um período definido. | Defina coorte, janela e evento de retorno. |
O artigo da NN/g sobre acompanhamento de métricas cita tempo, cliques, sucesso, facilidade percebida e retenção como exemplos de medidas que podem entrar em um programa. A escolha depende do produto e da pergunta. Um fluxo de emergência, por exemplo, pode exigir prioridade para sucesso e erro, enquanto uma experiência de conteúdo pode exigir retorno e encontrabilidade.
Task success precisa de uma regra objetiva
Antes da coleta, escreva o que conta como sucesso. Para uma assinatura, pode ser concluir o pagamento e receber a confirmação. Clicar no botão de assinatura sem confirmar o resultado pode ser apenas uma etapa intermediária. Regras diferentes produzem taxas diferentes e quebram a comparação.
Tempo não é sinônimo de qualidade
Uma tarefa mais rápida pode ser uma tarefa mais eficiente, mas também pode resultar de uma instrução que entregou a resposta, de uma amostra mais experiente ou de uma mudança que eliminou uma verificação importante. Leia tempo junto com sucesso, erros, ajuda e satisfação.
Escalas como SUS entram como medida de percepção
O System Usability Scale, conhecido como SUS, é um questionário de dez itens em escala de cinco pontos que produz um resultado de 0 a 100 após a interação. Ele pode ajudar a acompanhar uma percepção global de usabilidade, desde que a aplicação e o cálculo permaneçam consistentes. Para entender a fórmula e as limitações, consulte o guia da CamaraUX sobre escala SUS.
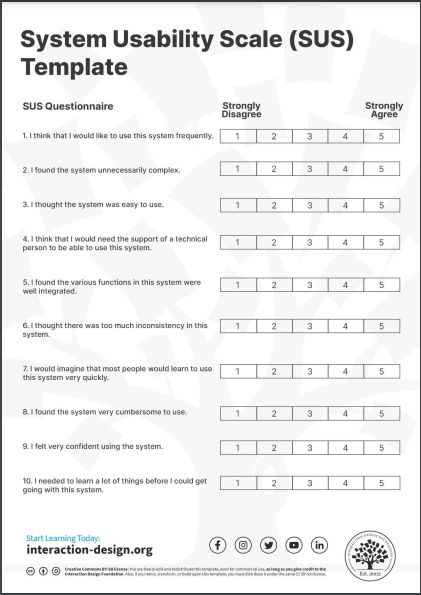
Não transforme uma nota de satisfação em diagnóstico. A escala informa a percepção declarada. Ela não explica qual etapa gerou o problema nem garante que uma melhora na nota tenha vindo de uma mudança específica.
Como definir amostra e segmentos
Não existe um número universal de participantes para todo benchmark. A amostra necessária depende da métrica, da variabilidade do comportamento, do tamanho do efeito que a equipe precisa detectar, dos segmentos e do risco da decisão.
O mais importante é combinar a pergunta com uma estratégia de amostragem. Para uma leitura de tarefa, recrute pessoas que realmente tenham o perfil e a experiência necessários. Para dados de analytics, defina o período, a população incluída, os eventos válidos e as regras para tráfego anômalo.
- Use um screener com critérios de inclusão e exclusão escritos.
- Registre experiência prévia, frequência de uso e contexto quando esses fatores puderem alterar a tarefa.
- Não misture segmentos que têm objetivos ou restrições diferentes sem sinalizar a mistura.
- Evite recrutar apenas pessoas convenientes, como colegas que conhecem o produto.
- Prefira novas amostras em rodadas sucessivas, mantendo critérios equivalentes, para reduzir efeito de aprendizagem.
Como garantir que as rodadas sejam comparáveis?
Comparabilidade é um trabalho de documentação. A NN/g recomenda preservar metodologia, tarefas, screener, variáveis dependentes e dados brutos em um repositório de pesquisa. Sem esses elementos, a equipe pode repetir o nome do estudo e, ainda assim, medir outra coisa.
| Elemento | O que manter estável | O que registrar se mudar |
|---|---|---|
| Tarefa | Objetivo, redação, ponto de início e condição de término. | Nova redação, nova funcionalidade ou novo dado fornecido. |
| Ordem | Sequência ou regra de randomização. | Motivo de uma ordem fixa ou alteração de blocos. |
| Instrução | Texto de abertura, incentivo e regras de ajuda. | Qualquer orientação extra dada pelo moderador. |
| Participantes | Critérios de perfil, experiência e exclusão. | Diferença de composição e tamanho de cada segmento. |
| Ambiente | Dispositivo, navegador, modalidade e ferramenta. | Falhas, atualização de plataforma ou troca de equipamento. |
| Métrica | Fórmula, unidade, denominador e regra de sucesso. | Nova definição, remoção de outlier ou recodificação. |
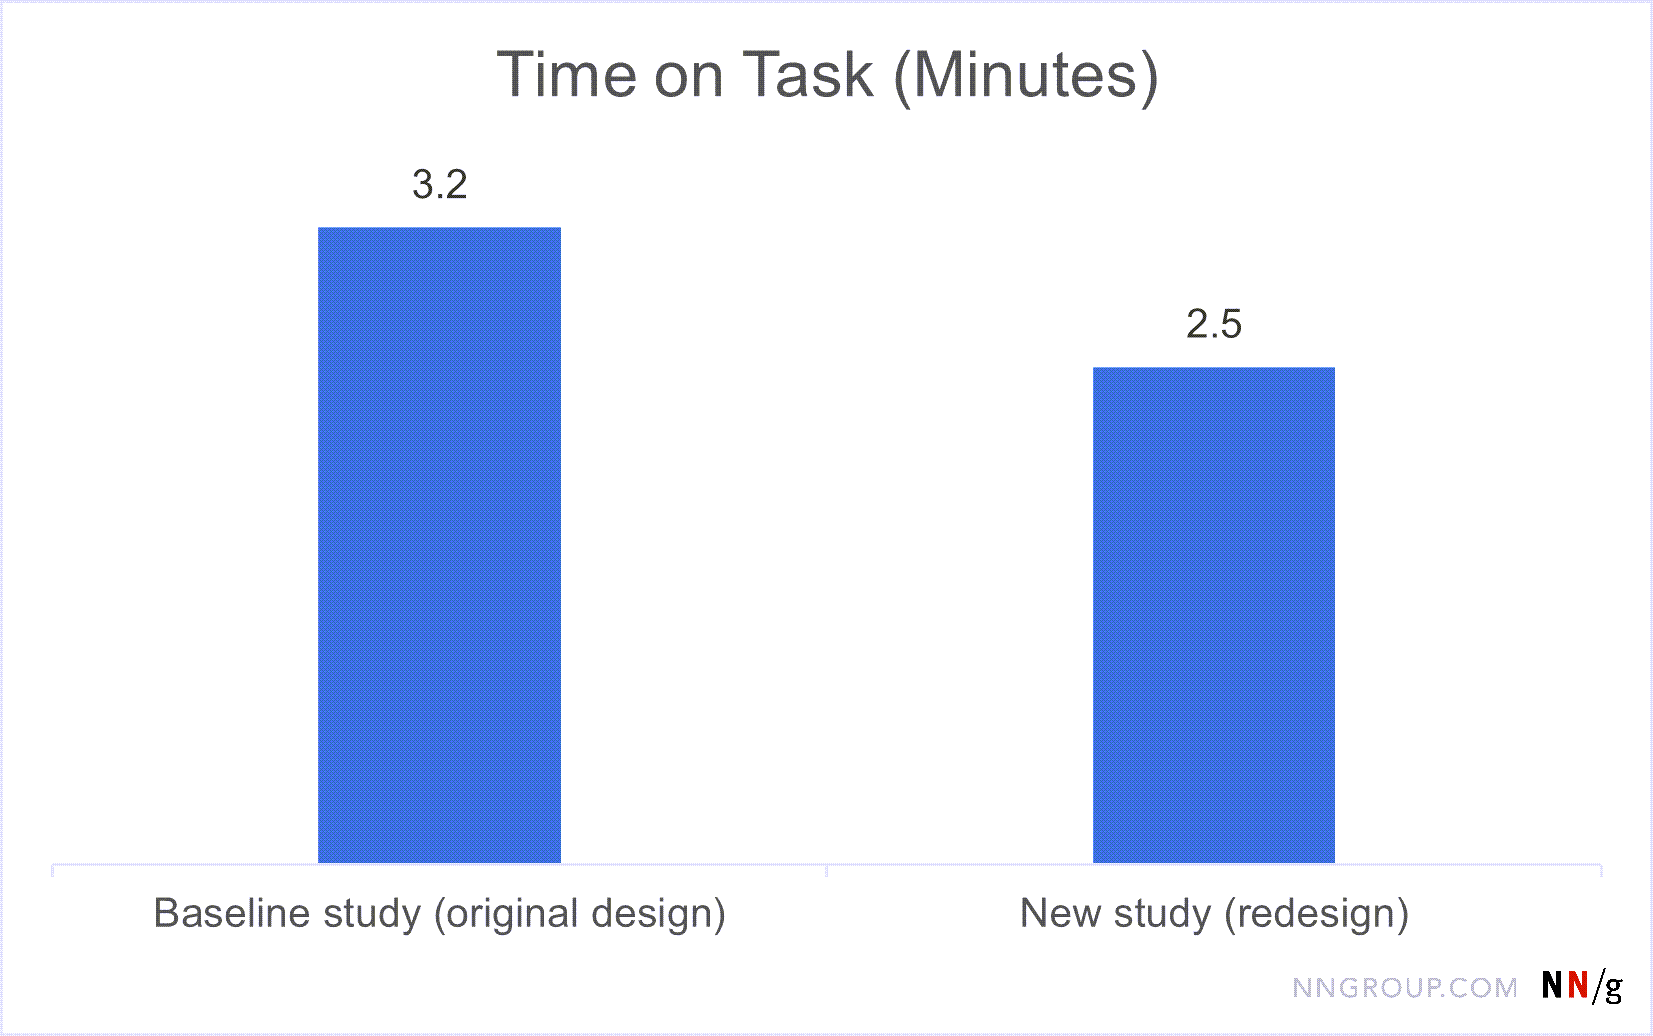
O repositório deve permitir que outra pessoa replique o estudo sem depender da memória de quem conduziu a rodada anterior. Inclua uma versão do protocolo, dicionário de métricas, roteiro, materiais de recrutamento, dados brutos, script de análise, decisões de exclusão e uma lista de alterações.
Como analisar os resultados sem exagerar a conclusão
A análise precisa separar três perguntas: qual foi a diferença observada, quanta incerteza existe nessa diferença e se ela é importante para a decisão. Um resultado pode ser estatisticamente detectável e ainda ser pequeno demais para justificar uma mudança. Também pode ser relevante para o negócio e exigir uma coleta mais robusta antes de uma conclusão definitiva.
- Diferença absoluta: subtraia a medida anterior da medida atual. É a forma mais fácil de conferir a unidade original.
- Diferença relativa: divida a diferença absoluta pela medida de referência. Sempre mostre também os valores absolutos.
- Distribuição: observe mediana, dispersão, percentis e casos extremos quando a métrica for numérica.
- Intervalo de incerteza: informe uma faixa compatível com o desenho do estudo e o tipo de dado.
- Significância e relevância: não use um p-valor como único critério para decidir; considere magnitude, risco, custo e impacto na tarefa.
Textos da IxDF sobre intervalos de confiança lembram que toda pesquisa contém erro. A porcentagem observada em uma amostra não é uma descrição perfeita de toda a população. O nível de confiança adequado depende do risco, do custo e da finalidade da decisão, e não deve ser escolhido como um selo universal de qualidade.
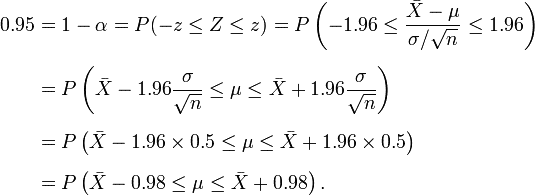
Como apresentar um relatório de benchmarking
Um relatório útil começa pela decisão e termina com uma ação. Evite abrir com um painel cheio de números sem contexto. Mostre o que foi medido, em qual versão, com qual público e por que aquela tarefa importa.
| Bloco do relatório | Pergunta que responde |
|---|---|
| Resumo executivo | Qual decisão o estudo apoia e qual é a principal evidência? |
| Escopo | Qual produto, versão, público, tarefa e período foram avaliados? |
| Método | Como a coleta, a codificação e a análise foram feitas? |
| Resultados | Quais medidas mudaram e com qual incerteza? |
| Interpretação | O que os dados permitem concluir e o que permanece aberto? |
| Decisão | O que será feito, medido novamente ou investigado? |
| Apêndice | Onde estão protocolo, dados, fórmulas e alterações? |
Gráficos de linha ajudam a visualizar séries temporais. Barras com intervalo de confiança ajudam a comparar estimativas. Distribuições e percentis são melhores do que uma média única quando há grande variação entre participantes. Em todos os casos, mantenha unidade, denominador, tamanho da amostra e data visíveis.
Para aprofundar a etapa de comunicação, veja o guia da CamaraUX sobre como transformar achados de UX Research em recomendações acionáveis. O princípio é o mesmo: evidência, implicação, limite e próximo passo precisam aparecer juntos.
Exemplo hipotético de benchmark em um cadastro
Considere um produto digital cujo cadastro é importante para ativar novos usuários. A equipe escreve a tarefa: “Crie uma conta usando os dados fornecidos e encontre a primeira ação recomendada”. O sucesso exige concluir o cadastro e chegar à ação recomendada. O estudo será feito com pessoas que ainda não usaram o produto.
| Elemento | Definição hipotética |
|---|---|
| Hipótese | Reduzir campos obrigatórios diminui o abandono sem aumentar erros de validação. |
| Métricas principais | Sucesso total, tempo mediano e abandono antes da confirmação. |
| Guardrail | Erros de validação e pedidos de ajuda não podem aumentar. |
| Baseline | Uma rodada com a versão atual e protocolo documentado. |
| Nova rodada | Mesma tarefa, critérios de recrutamento equivalentes e versão revisada. |
| Decisão | Manter a mudança, ajustar o fluxo ou investigar um segmento específico. |
Esse exemplo é apenas uma estrutura de planejamento. Os números, o tamanho da amostra e o resultado precisam vir da coleta real. Se o sucesso subir, mas os erros também subirem, a equipe não deve declarar vitória com base em uma única métrica. O benchmark torna esse trade-off visível para a decisão.
Erros comuns em benchmarking UX
- Começar pelo dashboard: escolher uma ferramenta antes de definir a decisão cria métricas sem uso.
- Tratar o benchmark como ranking: uma posição relativa não explica contexto, público, risco ou adequação.
- Mudar a tarefa a cada rodada: uma redação diferente pode mudar a compreensão e invalidar a comparação.
- Usar a média sem olhar a distribuição: poucos tempos extremos podem esconder o comportamento típico.
- Confundir correlação com causa: uma métrica melhor pode coincidir com campanha, sazonalidade, público diferente ou correção técnica.
- Não guardar dados brutos: sem o material original, a equipe não consegue revisar a análise nem testar uma nova hipótese.
- Comparar segmentos incompatíveis: usuários novos e especialistas podem ter tempos e taxas de sucesso naturalmente diferentes.
- Ignorar privacidade: gravações, respostas e dados de analytics exigem consentimento, minimização, controle de acesso e retenção adequada.
Para a parte de governança, o guia da CamaraUX sobre ética em UX Research ajuda a revisar consentimento, privacidade e tratamento dos dados antes de iniciar novas rodadas.
Ferramentas e fontes de dados para um benchmark
Benchmarking não depende de uma plataforma específica. A ferramenta deve servir ao protocolo e preservar a rastreabilidade da medida. Dependendo da pergunta, a equipe pode combinar:
- Teste quantitativo de usabilidade: tarefas com regras de sucesso, tempo e erro previamente definidas.
- Analytics: eventos, funil, conversão, retenção e recorrência em uma janela documentada.
- Questionários: escalas de facilidade, satisfação, confiança ou usabilidade aplicadas de forma consistente.
- Dados de suporte: volume e categoria de contatos sobre tarefas específicas, com regras de classificação estáveis.
- Planilha ou script: cálculo reproduzível, versionamento e registro de decisões analíticas.
- Repositório de research: protocolo, materiais, dados brutos, resultados, limites e decisões futuras.
O guia de métricas de UX sem vaidade pode ajudar a separar indicadores úteis de números que apenas parecem impressionantes. A pergunta continua sendo o filtro principal: qual decisão esse dado consegue informar?
Checklist de um estudo de benchmarking
- A decisão que depende do estudo está escrita?
- O produto, a versão, o período e o recorte estão registrados?
- As tarefas representam objetivos reais e têm critério de sucesso?
- As métricas têm fórmula, unidade, denominador e regra de dados ausentes?
- O público foi recrutado com critérios equivalentes e segmentos relevantes?
- O protocolo registra instruções, ordem, modalidade, ferramenta e regras de ajuda?
- Existe uma baseline antes da mudança?
- As hipóteses e métricas de proteção foram definidas antes do reteste?
- A análise mostra diferença absoluta, distribuição e incerteza?
- Os dados brutos, materiais e decisões estão arquivados?
- O resultado leva a uma decisão concreta ou a uma próxima investigação?
Perguntas frequentes sobre benchmark de UX
O que é benchmark de UX?
Benchmark de UX é uma prática de medir uma experiência com tarefas e métricas definidas, comparando os resultados com uma referência relevante. O estudo pode acompanhar versões do mesmo produto, uma meta ou outro padrão que faça sentido para a decisão.
Benchmark de UX precisa comparar concorrentes?
Não. Uma referência interna, como a versão anterior do produto ou uma baseline, costuma ser a forma mais consistente de acompanhar evolução. Referências externas podem complementar a análise, mas não são obrigatórias.
Quantos usuários são necessários para um benchmark UX?
Não existe um número universal. A amostra depende da métrica, da variabilidade, do efeito que precisa ser detectado, dos segmentos e do risco da decisão. Defina o plano de amostragem antes de coletar e registre suas limitações.
Quais métricas usar em um benchmark de UX?
Escolha poucas métricas complementares, como sucesso na tarefa, tempo, erros, abandono, ajuda e uma medida de percepção. A definição da tarefa, da fórmula e do denominador deve permanecer estável entre rodadas.
Com que frequência fazer benchmarking UX?
A frequência depende do produto, do custo da coleta, da velocidade de mudança e do risco da decisão. Uma equipe pode medir anualmente com teste quantitativo ou após grandes releases usando analytics, desde que o protocolo e a finalidade sejam claros.
Como garantir que duas rodadas sejam comparáveis?
Documente e mantenha equivalentes as tarefas, instruções, público, modalidade, dispositivo, ferramenta, critérios de sucesso e fórmulas. Registre qualquer alteração e avalie se ela limita a comparação com a baseline.
Conclusão
Benchmark de UX é um sistema de aprendizagem do produto. Ele começa com uma decisão, transforma tarefas importantes em medidas, estabelece uma baseline e repete a coleta em condições documentadas. O resultado mais valioso não é um número isolado, mas uma leitura que a equipe consegue reproduzir e usar para decidir.
Escolha poucas métricas, defina sucesso antes da coleta, preserve o protocolo, mostre a incerteza e arquive os dados brutos. Quando uma métrica mudar, investigue o contexto antes de atribuir o efeito a uma solução. É assim que benchmarking UX deixa de ser um relatório decorativo e passa a orientar evolução contínua.
Se você precisa estruturar um programa de medição, revisar suas métricas ou transformar resultados em uma decisão de produto, conheça a consultoria de UX da CamaraUX.
Fontes consultadas
- Nielsen Norman Group, “Benchmarking UX: Tracking Metrics”. Kate Moran, 2020. Definição, referências possíveis, momento de medir e exemplos de métricas.
- Nielsen Norman Group, “7 Steps to Benchmark Your Product’s UX”. Alita Kendrick, 2020. Processo de sete etapas para criar um programa de benchmarking.
- Nielsen Norman Group, “Documenting a UX-Benchmarking Study”. Raluca Budiu, 2023. Consistência, protocolo, tarefas, métricas, dados brutos e repositório.
- Nielsen Norman Group, “UX Benchmarking vs. UX Success Metrics”. Tim Neusesser, 2025. Vídeo sobre acompanhamento longitudinal e métricas de sucesso.
- Interaction Design Foundation, “Should We Introduce Benchmarking for our UX Research?”. IxDF, 2015. Propósito, foco, tarefas e necessidade de repetir o benchmark.
- Interaction Design Foundation, “What are Key Performance Indicators (KPIs) in UX Design?”. IxDF, atualização consultada em 2026. SUS, métricas de comportamento e framework de medição.
- Interaction Design Foundation, “Confidence Intervals and UX Research”. IxDF, 2015. Incerteza, amostra e interpretação de resultados.